 MOE融合算子
很久没有更新技术文档了诶!
这段时间一直在搞在网计算的相关事宜,看deepgemm的megamoe,看vllm-ascend的dispatch_ffn_combine算子;这俩其实都是MOE的融合算子,只是分别在不同框架下实现;他们的思想其实都差不多:
把本来拆开的 dispatch → 专家计算(FFN)→ combine,收进一个融合算子里。 带来的好处主要是:
- 少发 kernel、少同步:不再为 dispatch / 各 expert / combine 各起一轮,启动与同步开销明显下降,尤其 decode 小 batch 时更敏感。
- 少搬中间结果:token 路由后的中间张量不必反复写回再读出,显存带宽和临时 buffer 都能省一截。
- 通信与计算更好叠在一起:多卡 / 多机场景下,All-to-All 与 grouped GEMM 可在算子内部编排,比「先通信完再算、算完再通信」更容易 overlap。
- 算子内可做专家维度的批处理:按 expert 分组做 GEMM(grouped GEMM),访存更规整,也便于框架做图级融合与常量折叠。
二者只是落点不同:DeepGEMM 的 MegaMoE 偏 CUDA / GEMM 侧 融合,vLLM-Ascend 的 dispatch_ffn_combine 偏 昇腾图算子 融合——思想一致,都是把 MoE 整条数据通路尽量压进一次(或少数几次)下发里。
下面来各自总结一下这段时间看到的东西
# vllm-ascend 的 dispatch_ffn_combine 算子
源码在 vllm-ascend/csrc/mc2/dispatch_ffn_combine/。一次下发里把 路由(dispatch)→ 专家 FFN → 归并(combine) 串起来;昇腾上由两类核分工:AIC 做矩阵乘(Cube),AIV 做路由、激活与写回(Vector),910B 上大致是 1 个 AIC 配 2 个 AIV,两边用核间握手做流水,而不是「整张卡先通信、再计算」的两段式。
# 1. 扫参时先弄清哪些「尺度」
不必记实现里的符号表,只要把问题规模想清楚即可:
| 维度 | 在说什么 |
|---|---|
| 本卡 batch | 当前 rank 上有多少 token 要参与本轮 MoE |
| 隐藏维 / FFN 宽度 | 输入向量多长、第一层 FFN 扩到多宽(决定 GEMM 形状) |
| 每 token 选几个专家 | 路由的 fan-out;也决定后续要搬多少份、写回多少份 |
| 本卡管几个专家 | Expert Parallel 下,权重按卡切分,每张卡只算自己那几路 |
| EP 组里有几张卡 | 专家分布在多少 rank 上,跨卡通信规模由此决定 |
和性能、走哪条路径更相关的,还有三类直觉:
- 路由后的总条数(batch × 每 token 专家数):条数少时 combine 会走更细粒度的 V2 路径;条数多时用按专家组分块的 V1。
- 专家负载是否均匀:热门专家会分到更多 token,各 expert 组上的计算量可以差很多,扫参时要覆盖「偏斜」而不只测均匀分布。
- 跨卡共享内存是否够大:dispatch / combine 要在卡间共享区里暂存量化后的 token 与计数,规模随 batch、隐藏维、fan-out 一起涨。
每个专家上的实际 batch 不是本卡原始 token 数,而是 路由之后、所有卡汇到该专家上的行数——这才是 FFN 里 GEMM 真正吃的 batch。
# 2. 阶段划分与 AIC/AIV 时间线
启动后 AIC 与 AIV 同时开工:AIV 负责「把 token 分出去、再收回来」,AIC 负责「按专家做两层矩阵乘」;中间靠 完成信号 对齐,谁产出、谁消费,而不是整条链路等大同步。
| 阶段 | 谁在做 | 在做什么 | 同步要点 |
|---|---|---|---|
| 准备 | AIV | 按路由结果排序、量化,把本卡数据摆到 可被其它卡读取 的共享区,并记下「每个专家多少行、原 token 对应关系」 | 本卡内各核对齐 |
| 交换计数 | AIV | 各卡 只互换每个专家的行数(先不搬大段 token),据此算清后面要拉多少、写回写到哪 | 跨卡;不完成不能开始拉数据 |
| 通知计算核 | AIV → AIC | 行数表就绪后,允许 AIC 侧开始第一层 GEMM | 核间握手 |
| 拉取 token | AIV | 按 本地专家 逐组处理:从其它卡 主动读 属于本专家的量化 token,整理成连续块供 GEMM | 每组读完通知 AIC;不做全 EP 大屏障 |
| FFN 第一层 | AIC | 按专家组串行,组内再切块、多核并行做第一次大矩阵乘 | 等对应组的 token 到位 |
| SwiGLU | AIV | 对第一层输出做反量化、激活、再量化,常拆成 两波 与后面 GEMM 交错 | 与 AIC 用信号量流水 |
| FFN 第二层 | AIC | 第二次矩阵乘,仍按专家组 + 分块 | 等 SwiGLU 准备好输入 |
| Combine | AIV | 把本卡算好的专家输出 按路由写回 各目标卡上的共享区 | 只等本卡 GEMM 进度;combine 前 无 全 EP 屏障 |
| 跨卡对齐 | 全体 | 保证各卡写回区都写完 | 全 EP 屏障 |
| 收尾 | AIV | 按路由与门控权重,把多专家结果 还原成原 token 顺序 的输出 | — |
可交叠关系(流水线,不是严格串行):
| 交叠 | 直观理解 |
|---|---|
| 拉第 i 个专家的数据 ↔ 算第 i−1 个专家的 FFN 前半 | 数据一到就能算,不必等所有专家都拉完 |
| FFN 前半(部分专家) ↔ SwiGLU 第一波 | 先算完的专家可以先过激活 |
| SwiGLU 第二波 ↔ FFN 第二层(前几组) | 第二层 GEMM 与剩余激活并行推进 |
| FFN 第二层(某组) ↔ Combine(同组) | 输出可以按组写回,不必等所有专家都算完 |
时间线图(AIV / AIC 按 expert 组流水;虚线框标出三组交叠):

提示:点击上图可全屏放大;放大后可拖动查看细节,再次点击或按 Esc 关闭。
# 3. Dispatch(重点)
三步走
- 本地整理:本卡 token 按目标专家归类、量化,放进共享区,并生成路由元数据(每个专家几行、与原 batch 的对应关系)。
- 只换「清单」:各卡互相告知「我这边每个专家有多少行要给你们」,用很小的跨卡写入 + 轮询完成;据此确定后续要读多少、combine 时写到哪里。整包 token 此时还不搬。
- 按专家拉数据:对本卡负责的每个专家,从其它卡共享区 主动读取 属于自己的行,拼成连续块,再交给 AIC 做 FFN。
多核怎么分工
- 遍历顺序:先固定专家,再扫来源卡(与 combine 对称)。
- 多个 AIV 核按来源卡分片搬运;每完成一个专家组,本卡内对齐一次,并通知 AIC「这一组可以算了」。
- 粒度是 专家组的一批 token,不是来一行算一行。
为什么计数用 Push、数据用 Pull
- 计数 Push:发送方写一小块「就绪信息」,便于各卡快速对齐。
- 数据 Pull:接收方按清单决定读多少、写到哪,能和 按专家组的 GEMM 流水衔接,也便于控制带宽与缓冲,避免发送方盲目灌满。
同步边界
| 边界 | 是否跨卡 | 含义 |
|---|---|---|
| 开始拉 token 之前 | 是 | 各卡专家行数必须对齐,否则不知道读多长 |
| 每个专家组拉完之后 | 否 | 仅本卡内通知 AIC;各卡进度可以不一致 |
# 4. Combine(重点):V1 与 V2
目标:把本卡上 已按专家排好 的 FFN 输出,根据路由 写回 各 token 所属卡上的共享区;最后再按路由与门控做加权还原。
怎么选路径:当「本卡 batch × 每 token 专家数」不超过约 4096 时走 V2(更细的分块);否则走 V1(按专家组整块处理)。
| V1(大批量) | V2(小批量) | |
|---|---|---|
| 并行方式 | 按 专家组 切;组内再按来源卡分给各 AIV 核 | 与 GEMM 类似,切成 更小的二维块,块内再分给子核 |
| 与 FFN 第二层 | 通常 整组 算完再写回 | 算出一小块就可以写回一块,减少空等 |
| 更适合 | 专家多、每段数据量较均匀 | token 少或负载不均,避免「整组等齐」 |
遍历顺序:与 dispatch 一样,外层专家、内层来源卡(V2 只是在组内再多一层小块网格)。
同步边界
| 边界 | 是否跨卡 | 含义 |
|---|---|---|
| Combine 之前 | 否 | 只等本卡 FFN 第二层进度;各卡可先后开始写回 |
| Combine 之后、还原输出之前 | 是 | 必须保证各卡写回区都可见,因为还原时要读 别的卡 上的结果 |
# 5. 计算:两层 GEMM 与 SwiGLU
标准 MoE FFN 的三段在这里仍成立,只是嵌进融合核里:
- 第一层 GEMM:把路由来的 token 块 × 第一层权重,得到较宽的中间表示。
- SwiGLU:向量核上做反量化 → 激活 → 再量化,得到第二层输入;实现上常 分两波,以便和后面的 GEMM 交错。
- 第二层 GEMM:再乘第二层权重,得到该专家上的输出,供 combine 写回。
AIC 侧:每个专家组内,把矩阵乘 切成小块,多块分给多个 AIC 核并行;组与组之间 串行,组内还要等 AIV 把该组 token 拉齐。
AIV 侧:SwiGLU 按 连续多行 处理;第一波不必等所有专家的第一层 GEMM 都结束——与上文「可交叠」一致。
整体仍是:按专家批处理 + 核间流水,用较少的全局屏障换更高的 overlap。
# DeepGEMM 的 MegaMoE 算子
实现落在 DeepGEMM:sm100_fp8_fp4_mega_moe(Blackwell / SM100)与 sm90_fp8_mega_moe(Hopper / SM90)。与拆开跑的 dispatch → 两段专家 GEMM → SwiGLU → combine 在语义上一致,但合并成 一次下发。下文时间线以 SM100 的线程分工为主(TMEM + 独立 Epilogue warp);SM90 的差异在文末点明。
核心调度不是「整层串行四段」,而是 expert-wave:
路由交换 → Dispatch(Pull,按 BLOCK_M 与 GMM1 交叠)
  → 对每个 expert-wave(波宽 kNumExpertsPerWave):
        整波 Linear1:GMM1 + SwiGLU(融在 L1 epilogue)
        整波 Linear2:GMM2 + 散写(融在 L2 epilogue)
  → 全组栅栏 → Combine 加权归并
2
3
4
5
# 0. 和 dispatch_ffn_combine 是不是一回事?
逻辑上基本是同一条路:先对齐「每个专家要收多少 token」→ 把 token 拉进本卡专家池 → 两层 FFN(矩阵乘 + SwiGLU)→ combine(先 散写 回各源卡,再 加权归并)。差别主要在 硬件怎么分工与调度切分键(MegaMoE 是 expert-wave;昇腾样例更常按 expert 组 / microbatch):
| vLLM-Ascend | DeepGEMM MegaMoE(SM100) | |
|---|---|---|
| 谁算矩阵、谁管路由 | AIC 专做 GEMM,AIV 做路由、激活、写回 | Dispatch warp 计数与 Pull;MMA warp 做两层 UMMA;Epilogue warp 做 L1 的 SwiGLU / L2 的散写与最终 Combine |
| 跨卡怎么传 | 卡间共享区;计数先推、数据后拉 | 多卡 对称显存 + NVLink 轻量栅栏(不走 NCCL 大包) |
| Combine | 按 batch 规模选粗/细写回路径 | L2 epilogue 按块散写 → 全组栅栏 → Epilogue warp 做 top-k 加权归并 |
| 数值与平台 | 量化 token 在池里周转 | SM100:FP8×FP4→BF16;SM90:FP8×FP8→BF16(Hopper 有独立实现) |
理解 MegaMoE 需要两层:逻辑依赖仍是 Pull → L1(+SwiGLU) → L2(+散写) → 归并;调度则是波内「先全 L1、再全 L2」,并在 Pull∥L1、L1 内 MMA∥SwiGLU(TMEM)、L2 内 GMM2∥散写 上重叠。
# 1. 扫参时先弄清哪些「尺度」
| 维度 | 在说什么 |
|---|---|
| 本卡 batch | 当前 rank 参与本轮 MoE 的 token 数 |
| 每卡 token 上界 | Host 按最大 batch 预分配;超出直接报错 |
| 隐藏维 / FFN 宽度 | 决定两层 GEMM 的形状 |
| 每 token 选几个专家(top-k) | 路由 fan-out;影响搬运量与 combine 面数 |
| 本卡管几个专家 | EP 下权重按卡切分 |
| 对称工作区大小 | 输入、收发清单、专家池、combine 暂存区共用一块跨卡可见显存,随 batch、隐藏维、top-k 一起涨 |
| 每个专家大概分到多少 token | 全局 token×top-k 摊到专家数上的平均值,用来选矩阵分块、一次 wave 推进几个专家 |
| 「这一批到齐了吗」 | 路由侧每搬进一批(BLOCK_M 条)记一笔;矩阵乘侧凑够该批才算第一层可开算 |
分块策略会随 decode / prefill 的典型负载在 Host 侧自动调整,没有单独的 prefill/decode 模式开关。每个专家上 GEMM 实际吃的 batch,是 路由后各卡汇到该专家的总行数,不是本卡原始 token 数。
# 2. 阶段划分与三组线程流水(SM100)
一次 launch 里,同一 CTA 内按 warp 角色分叉(不是整张卡先通信再计算):
| 角色 | 典型职责 |
|---|---|
| Dispatch warp | 路由计数、写工单、NVLink Pull、清工作区 |
| MMA warp | Linear1 / Linear2 的 UMMA(经 TMEM 交给 Epilogue) |
| Epilogue warp | L1:从 TMEM 取数做 SwiGLU(+量化);L2:BF16 epilogue + 散写;最后做 Combine 归并 |
| 阶段 | 谁在做 | 在做什么 | 同步要点 |
|---|---|---|---|
| 路由 · 本地统计 / 写清单 | Dispatch | 扫 token×专家槽,写跨卡可见工单 | 本卡对齐 |
| 路由 · 交换条数 | Dispatch(主控) | 各卡告知每 expert 条数;仍不搬大包 | 跨卡 |
| 跨卡对齐(拉数据前) | 全体相关路径 | 清单与条数可见 | NVLink 栅栏;并与 Epilogue 侧握手后再 Pull |
| 拉取 token | Dispatch | 按调度从源卡 Pull 进专家池;每满 BLOCK_M 行递增到齐计数 | 与 MMA 无全局串行 |
| Linear1 · GMM1 | MMA | 专家池 × 第一层权重 → TMEM | 等对应 数据批 到齐 |
| Linear1 · SwiGLU | Epilogue | 读 TMEM → SwiGLU → 写 L2 输入池 / SF;置 l2_arrival | L1 波内可与后续 GMM1 tile 经 TMEM 分段重叠;不是独立「激活大阶段」 |
| Linear2 · GMM2 | MMA | 消费 L2 池 | 须等本 expert-wave 的全部 Linear1 结束;再按批等该 m_block 的 L1 N tile 就绪 |
| Linear2 · 散写 | Epilogue | 第二层 BF16 按元数据写到源 rank 的 combine 面 | 散写过程中 无 全组大等待 |
| 跨卡对齐(归并前) | 全体 | 各卡散写完成 | 全 EP nvlink_barrier |
| Combine · 归并 | Epilogue | 本卡 token 各 top-k 面加权累加 → y | 与 Dispatch「清空工作区」同窗 |
| 清场 | Dispatch | 清 workspace | 归并之后 / 同窗;再跨卡栅栏 |
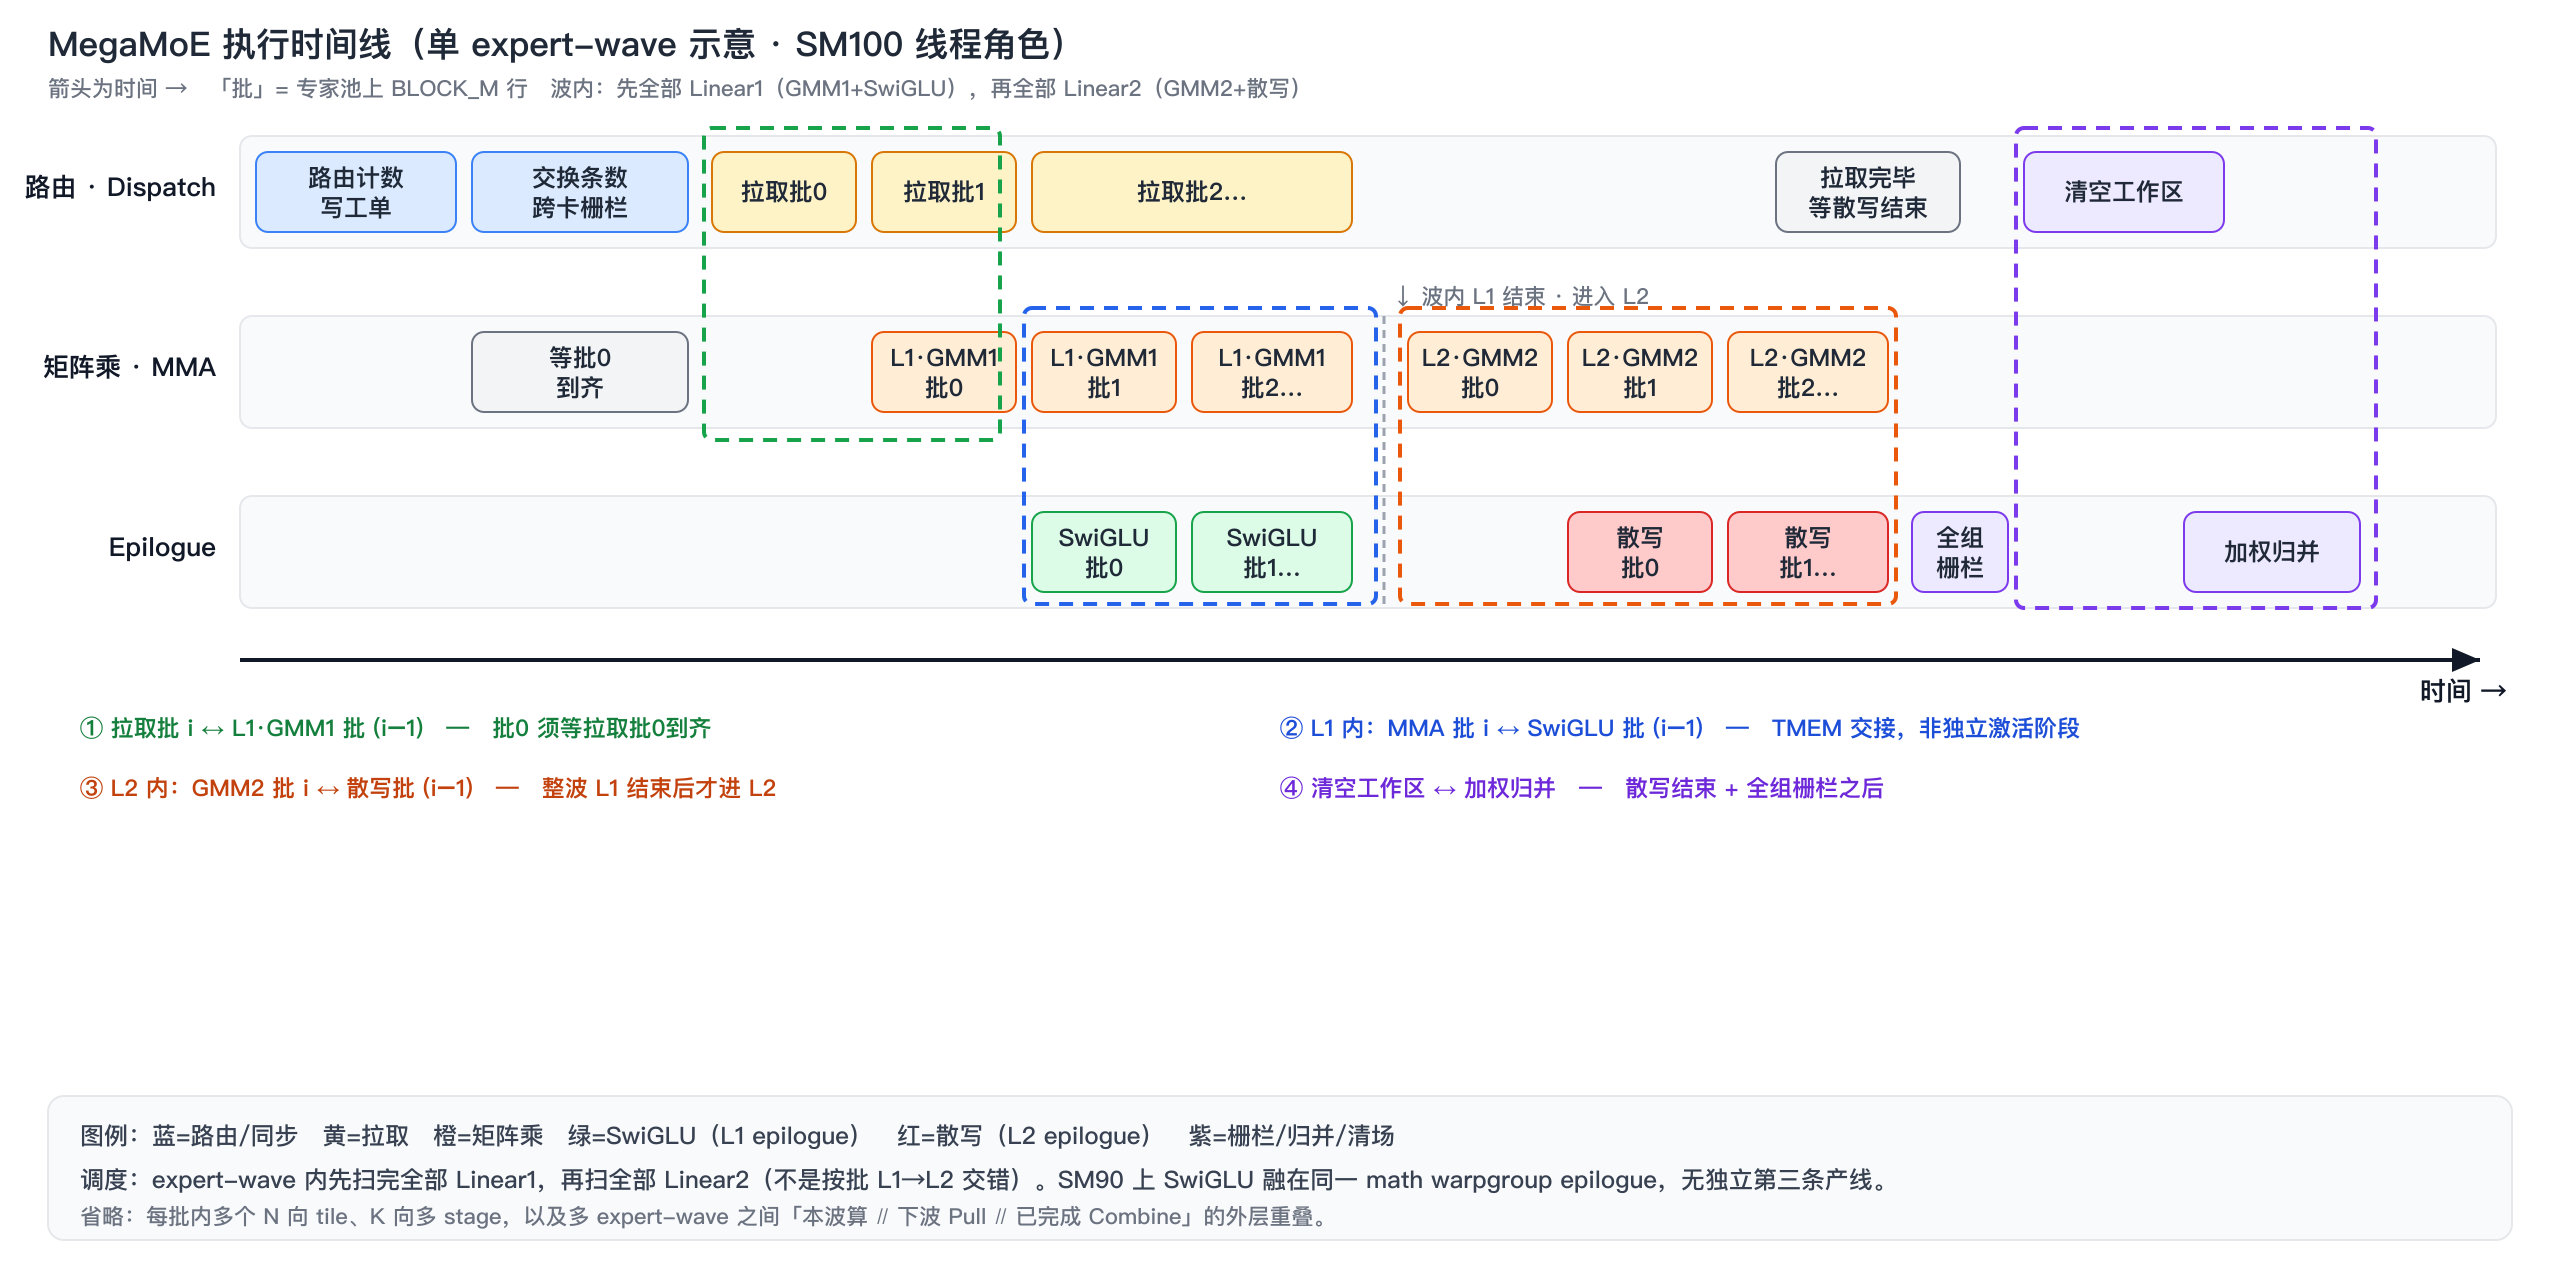
可交叠关系(流水线,不是严格串行):
| 交叠 | 直观理解 |
|---|---|
| 拉第 i 批 ↔ L1·GMM1 第 i−1 批 | 搬进一批记一笔;该批到齐即可开算,不必等所有专家都拉完 |
| L1 内:GMM1 批 i ↔ SwiGLU 批 i−1 | MMA 与 Epilogue 经 TMEM stage 交接;仍同属 Linear1 |
| 整波 Linear1 结束 → 才开整波 Linear2 | Scheduler:kNumExpertsPerWave 内先扫完所有 L1 tile,再扫 L2(不是按批 L1→L2 交错) |
| L2 内:GMM2 批 i ↔ 散写批 i−1 | 同属 Linear2;散写挂在 L2 epilogue |
| 清空工作区 ↔ 加权归并 | 均在散写结束 + 全组栅栏之后 |
MMA warp 不参加 Dispatch/Epilogue 的粗粒度握手,只靠到齐计数、TMEM full/empty 与组内 K 流水推进。
时间线图(Dispatch / MMA / Epilogue;虚线框为互不重叠的四组交叠示意):
提示:点击上图可全屏放大;放大后可拖动查看细节,再次点击或按 Esc 关闭。
# 3. Dispatch(重点)
三步走
- 本地整理:各 SM 扫本单元负责的 token×top-k,统计各 expert 条数,并把起始 slot 写回 workspace。
- 只换「清单」:主控 SM 把「每个 expert 会收到多少条」写到目标 rank;大包 token 仍不搬。中间本卡
grid_sync+ 跨卡 NVLink 栅栏。 - 按批拉数据:按全局扁平序轮转各 local expert;查工单得源 rank、源 token → TMA 搬进专家池,写入 combine 所需的来源元数据。
遍历与搬运
- 外层 先 expert、再来源 rank 的轮转(「剥洋葱」round-robin),多源 token 交错进池,避免单卡塞满。
- 工单存
token_idx × topk + slot;后续散写靠元数据反查写回地址。 - 计数偏 Push、数据偏 Pull:发送方写 recv 条数与 slot;接收方按清单主动拉——与按
BLOCK_M批的第一层 GEMM 流水衔接。
同步边界(记两条)
| 边界 | 是否跨卡 | 含义 |
|---|---|---|
| 开始拉数据之前 | 是 | 各卡条数与工单必须一致,否则不知道读多长 |
| 每一数据批拉完之后 | 否 | 只通知本卡矩阵乘组;各卡、各专家进度可不同 |
# 4. Combine(重点):散写与归并
Combine 拆成 散写(Scatter) 与 归并(Reduce) 两段,中间夹一次全 EP 对齐:
| 散写 | 归并 | |
|---|---|---|
| 做什么 | 第二层算出的 BF16,按元数据写到 源 token 所在 rank 的 combine_token_buffer(按 top-k 分面) | 每 rank 只处理 本 rank token:从各 top-k 面 TMA 读出,寄存器 FP32 累加(可叠 gate),再写最终 y |
| 并行 | 按 scheduler 的 L2 tile;算完一块即可散写一块(Epilogue) | 按 token×hidden chunk 双缓冲,掩盖 TMA 延迟(复用 Epilogue warp) |
| 与第二层关系 | 不必等所有 expert 的第二层都算完;但须已进入本波 Linear2 | 必须等 全体 rank scatter 完成 |
| 跨卡 | 单次写经 NVLink 直达对端,过程中 无 集体等待 | 归并前有 nvlink_barrier |
负载偏斜时,瓶颈常在 热门 expert 池变长、scatter 写放大 与 combine 面多读;扫参宜覆盖不均匀路由,而不只测均匀分布。
同步边界
| 边界 | 是否跨卡 | 含义 |
|---|---|---|
| 散写过程中 | 否(单次写可跨卡,但无集体等待) | 各卡 Epilogue 进度可不同 |
| 归并之前 | 是 | 必须能读到别卡散写来的结果 |
| 归并之后 | 否 | 输出已是本卡最终布局 |
# 5. 计算:两层 GEMM 与 SwiGLU
标准 MoE FFN 三段,嵌在 Blackwell UMMA + TMEM 路径里:
- 第一层(Linear1 / GMM1):专家池 FP8 × FP4 权重(常 2-SM cluster UMMA)→ 累加进 TMEM;TMA 与 MMA 多 stage K 流水。
- SwiGLU(L1 epilogue):Epilogue warp(不是第三条「激活专用产线」)从 TMEM 取数 → SwiGLU(可叠 top-k 权重)→ 再量化写 L2 池 / SF,并更新该
m_block的就绪掩码。 - 第二层(Linear2 / GMM2):消费 L2 池 → UMMA → Epilogue 转 BF16 → 散写 到 combine 面。
MegaMoEScheduler 在 Linear1 / Linear2 间切换:按各 expert 的 recv 条数切 M×N block;同一 kNumExpertsPerWave 窗口内先完成全部 Linear1,再进入 Linear2。Host 侧 get_num_experts_per_wave_for_mega_moe* 用「一波 L1 tile 是否喂饱 SM」等启发式选定波宽,并保证整除 num_experts_per_rank。
与 SM90 的差异(避免把两张图混读):Hopper 路径 没有独立 Epilogue/TMEM 角色——SwiGLU 融在 同一 math warpgroup 的 GMM1 epilogue 里;Pull∥GMM1 与「波内先 L1 后 L2」的调度框架仍相同。
小结(MegaMoE):单 kernel 内完成 对齐收发规模 → Pull 进专家池 →(按 expert-wave)整波 L1(+SwiGLU) → 整波 L2(+散写) → 全组对齐 + 归并;优势来自 一次 launch、少中间落盘、NVLink 对称内存上的通信与计算交叠,以及 Pull/TMEM/L2 epilogue 多级流水——而不是把激活再拆成与矩阵乘对等的第三条全局阶段。